Năm
2024
Vai trò
Cài đặt toàn bộ — dataset, hàm mất mát, module attention, huấn luyện
Công nghệ
- PyTorch
- YOLOv1
- CBAM
- ReduceLROnPlateau
Nghiên cứu kiến trúc
YOLOv1 With CBAM From Scratch
Cài đặt lại YOLOv1 từ con số không bằng PyTorch — dataset riêng, hàm mất mát riêng — rồi bổ sung CBAM để đo xem attention đóng góp gì cho một detector một giai đoạn.
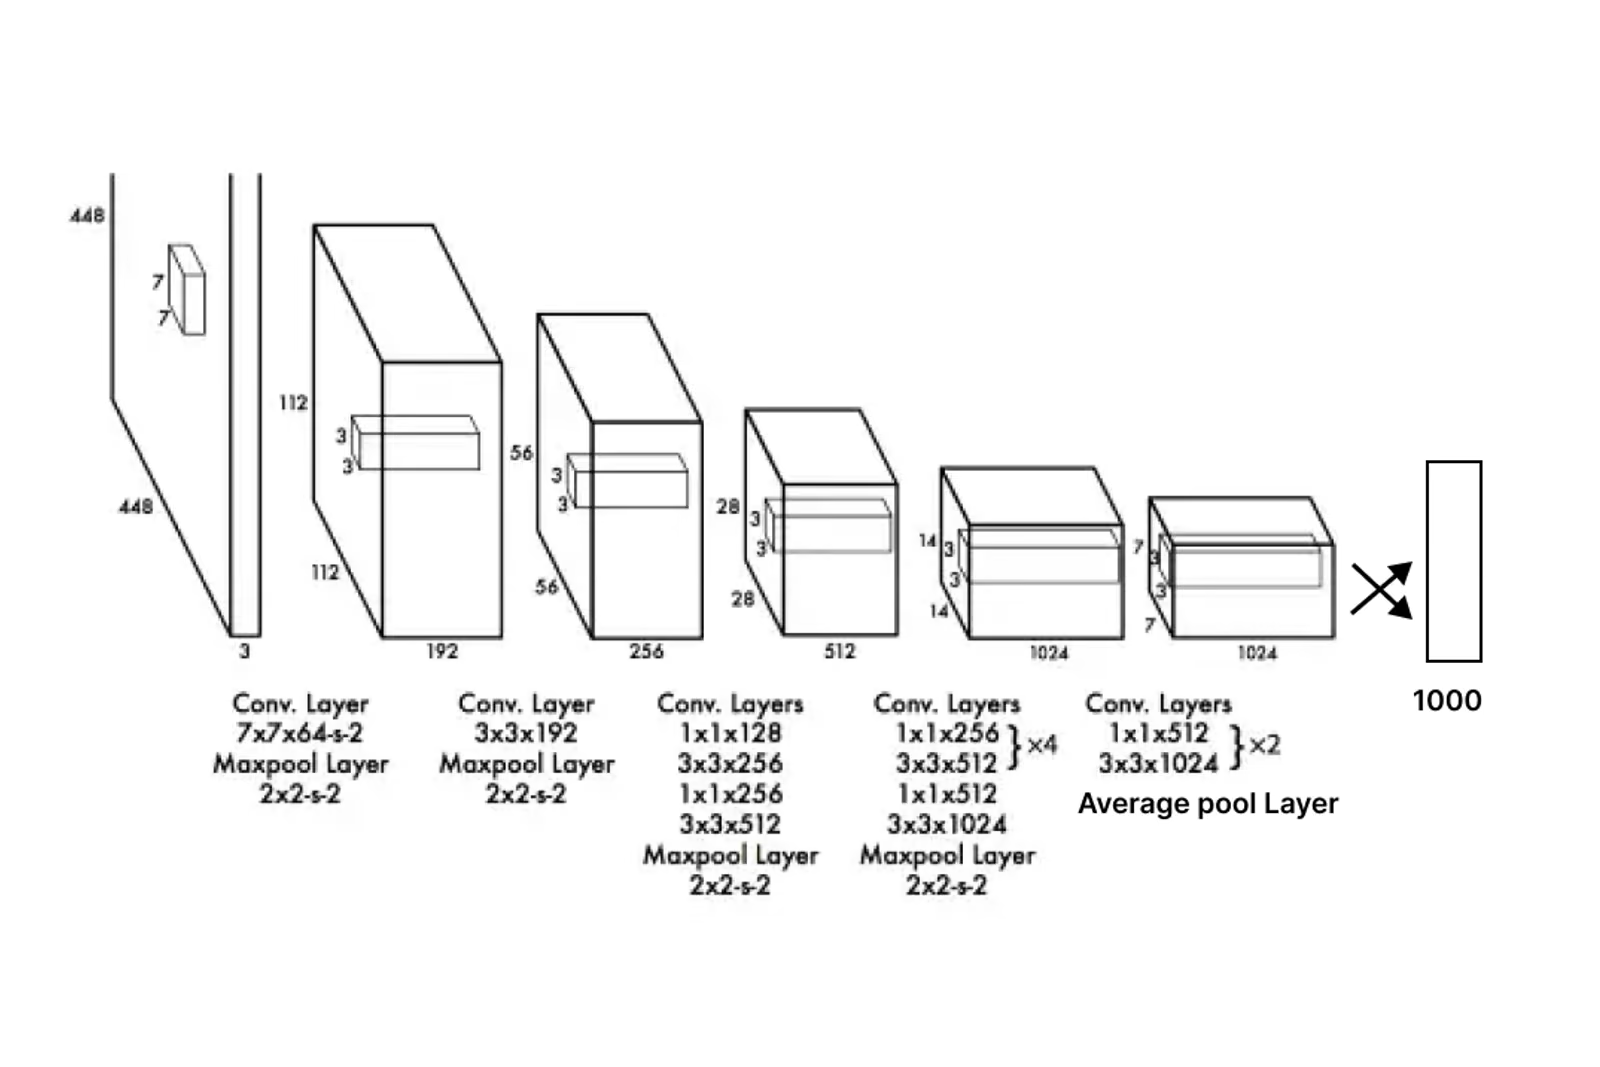
- Dự án dựng lại mô hình YOLOv1 từ đầu bằng PyTorch, trong đó tôi cài đặt FruitDataset và YoloLoss, đồng thời tích hợp CBAM (Convolutional Block Attention Module) để tăng cường trích xuất đặc trưng, với tổng cộng 269.168.434 tham số.
- Mô hình sử dụng bộ lập lịch ReduceLROnPlateau để tối ưu quá trình huấn luyện.
- Kết quả huấn luyện cho thấy Train mAP đạt 0.8829 và Best Validation mAP đạt 0.6994.
- Những kết quả này chứng minh CBAM mang lại cải thiện đáng kể cho hiệu năng phát hiện đối tượng.
- mAP huấn luyện
- 0.8829
- mAP validation tốt nhất
- 0.6994
- Tham số
- 269.2M
Mục tiêu
Cài đặt lại YOLOv1 từ bài báo thay vì clone một repo, rồi dùng chính bản cài đặt đó làm môi trường thí nghiệm có kiểm soát cho một câu hỏi duy nhất: attention theo kênh và theo không gian mang lại gì cho một detector một giai đoạn?
Viết từ đầu chính là thứ khiến câu trả lời đáng tin. Trong một codebase tôi không tự viết, một phép ablation chỉ đo được chênh lệch giữa hai cấu hình mà tôi không hiểu trọn vẹn.
Những gì tôi đã cài đặt
FruitDataset— nạp ảnh, tăng cường dữ liệu, và phép mã hoá biến bounding box thành tensor mục tiêu dạng lướiS × S × (B·5 + C)của YOLO. Phép mã hoá này là phần rắc rối nhất của YOLO và là chỗ mà một lỗi tinh vi sẽ tạo ra mô hình huấn luyện mãi mà không hội tụ.YoloLoss— hàm mục tiêu nhiều thành phần: hồi quy toạ độ, độ tin cậy cho ô lưới có chứa vật thể, độ tin cậy cho ô không chứa, và phân loại. Hai trọng sốλ_coordvàλ_noobjtồn tại vì đại đa số ô lưới là ô trống; nếu không giảm trọng số chúng, thành phần no-object sẽ nhấn chìm mọi thành phần còn lại.- CBAM — Convolutional Block Attention Module, áp dụng lần lượt attention theo kênh (feature map nào quan trọng) rồi attention theo không gian (vị trí nào trong map quan trọng).
Tổng cộng 269.168.434 tham số. Quá trình huấn luyện dùng ReduceLROnPlateau, giảm learning rate khi validation ngừng cải thiện.
Kết quả
mAP huấn luyện 0,8829, mAP validation tốt nhất 0,6994.
CBAM cải thiện hiệu năng phát hiện một cách rõ rệt — các module attention giúp mạng ức chế nền và tập trung vào vùng chứa vật thể, đúng vào kiểu lỗi mà một detector một giai đoạn dựa trên lưới hay mắc phải.
Khoảng cách 0,18 giữa train và validation là cách đọc trung thực còn lại của các con số này: đây là mô hình 269 triệu tham số, và một khoảng cách cỡ đó cho thấy nó dư năng lực so với lượng dữ liệu. Trên một bộ ngữ liệu lớn hơn, chính con số validation mới là con số sẽ dịch chuyển.
Điều tôi rút ra
Tự tay viết hàm mất mát dạy tôi về YOLO nhiều hơn đọc bài báo. Trọng số λ_noobj chỉ là một dòng code, mà nó mã hoá đúng vấn đề cấu trúc trung tâm của phát hiện một giai đoạn — một sự thật hoàn toàn vô hình cho tới khi bạn phải tự chọn con số ấy.