Năm
2025
Vai trò
Phương pháp đo đạc, profiling, phân tích
Công nghệ
- TensorRT
- ONNX Runtime
- TorchScript
- torch.compile
- Nsight
- CUDA
Hiệu năng hệ thống
Optimization for AI Inference Engines on GPUs
Nghiên cứu hệ thống về tối ưu suy luận trên GPU cho ResNet50 và DistilBERT — FP16, lượng tử hoá INT8, TorchScript, torch.compile và ONNX — đo đạc thay vì phỏng đoán.
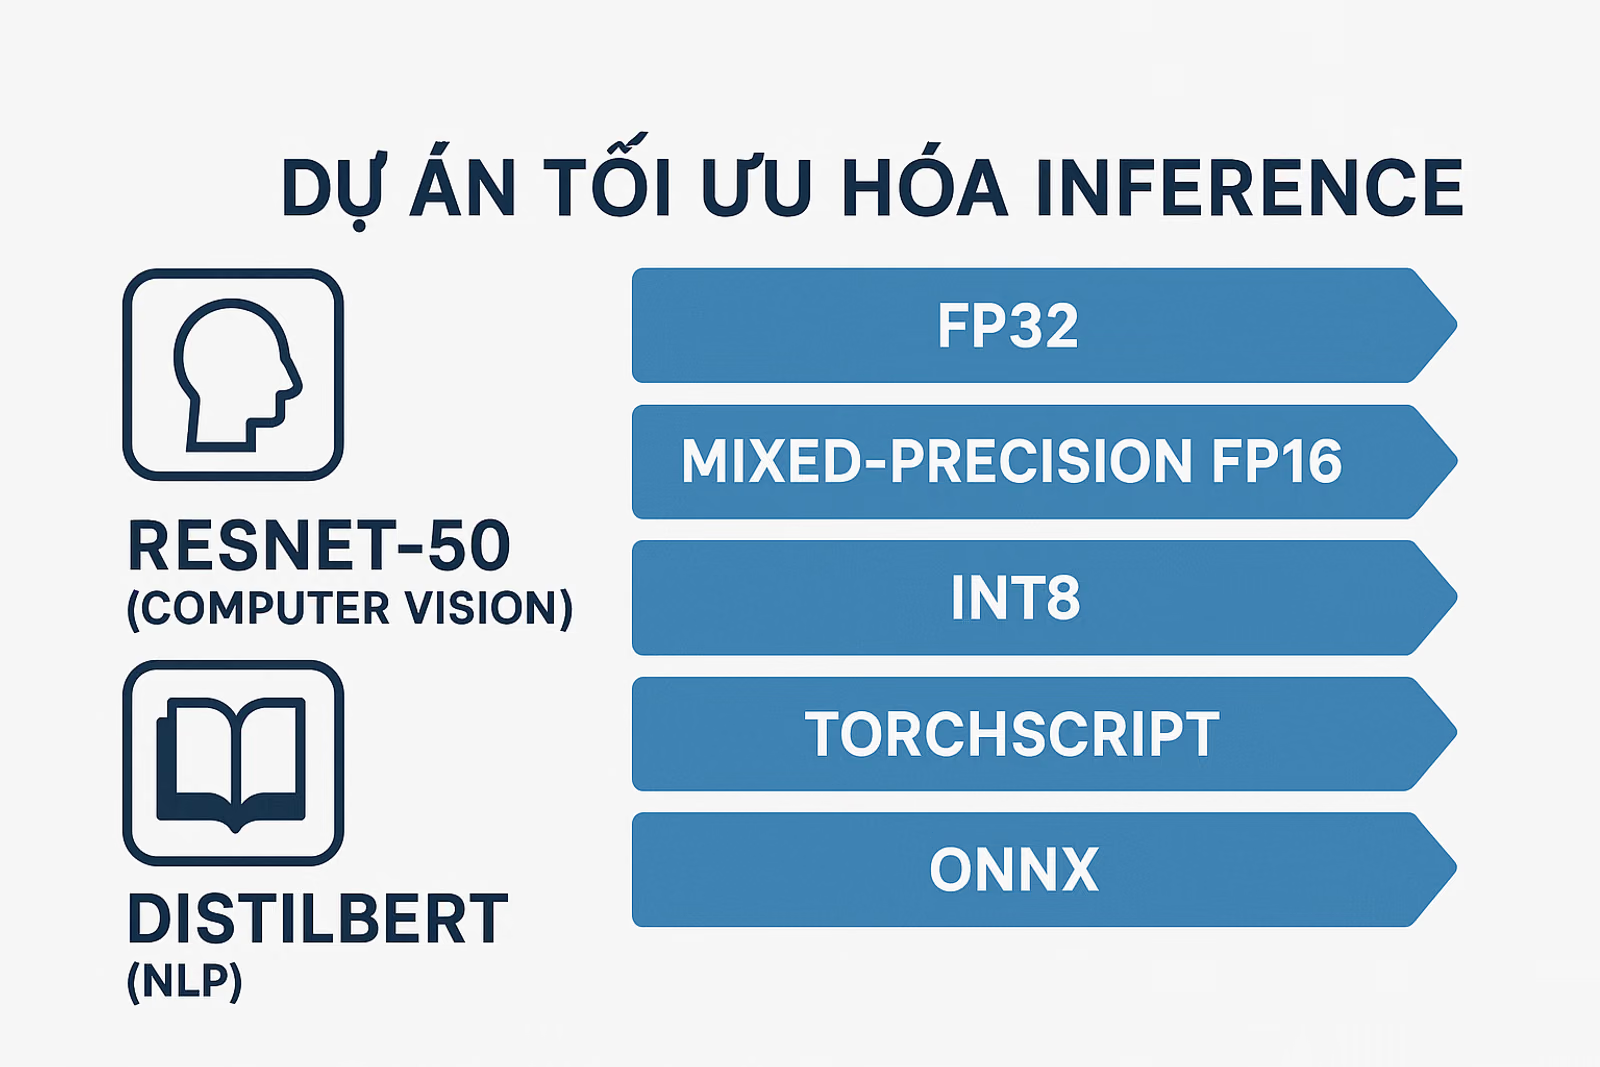
- Dự án tập trung tối ưu suy luận AI trên GPU cho ResNet50 và DistilBERT thông qua FP16, INT8, TorchScript/torch.compile và ONNX.
- Kết quả cho thấy FP16 mang lại cải thiện đáng kể, đặc biệt với DistilBERT: thông lượng tăng từ 305 → 1202 mẫu/s ở batch size 8 (≈4×).
- INT8 (TensorRT) đạt tăng tốc 2–5× nhưng đòi hỏi hiệu chuẩn cẩn thận để giữ được độ chính xác.
- Tối ưu đồ thị cho tăng tốc 1,2–1,8×, trong khi profiling CUDA xác định các nút thắt chính nằm ở kernel GEMM và ReLU.
- Dự án chứng minh mixed-precision và lượng tử hoá là những cách tiếp cận hiệu quả nhất cho suy luận quy mô lớn.
- Thông lượng FP16
- 4×
- DistilBERT
- Tăng tốc INT8
- 2–5×
- TensorRT
- Tối ưu đồ thị
- 1.2–1.8×
Bài toán
Huấn luyện là thứ được chú ý; suy luận mới là thứ trả hoá đơn. Một mô hình chạy trong môi trường thực thi hàng triệu lượt forward, và khoảng cách giữa một vòng lặp PyTorch .eval() ngây thơ với một engine được tối ưu đúng cách thường xấp xỉ một bậc độ lớn.
Tôi đo các kỹ thuật tối ưu trên hai khối lượng công việc cố ý chọn khác nhau — ResNet50 (tích chập, thị giác) và DistilBERT (transformer, ngôn ngữ) — vì các kỹ thuật này không chuyển giao đồng đều giữa chúng, và một phép đo trên đúng một mô hình sẽ che giấu chính điều đó.
Những gì đã đo
Độ chính xác hỗn hợp (FP16) là chiến thắng đơn lẻ lớn nhất, và lớn một cách chênh lệch với DistilBERT: thông lượng tăng từ 305 lên 1202 mẫu/s ở batch size 8 — tức khoảng 4 lần. Suy luận transformer bị chi phối bởi các phép GEMM dày kích thước lớn, vốn ánh xạ thẳng lên tensor core; giảm một nửa độ chính xác đồng thời giảm một nửa lưu lượng bộ nhớ và tăng gần gấp đôi thông lượng số học. ResNet50 cũng cải thiện, nhưng ít hơn — các phép tích chập vốn đã được phục vụ tốt.
INT8 qua TensorRT cho 2–5×, biên độ rộng nhất trong nghiên cứu và cũng phụ thuộc điều kiện nhiều nhất. INT8 cần một lượt hiệu chuẩn để khớp dải giá trị activation, và một tập hiệu chuẩn chọn kém sẽ đánh đổi độ chính xác theo cách mà không tốc độ nào bù nổi. Mức tăng tốc là có thật; nhưng nó không miễn phí.
Tối ưu đồ thị — TorchScript, torch.compile, xuất ONNX — cho mức 1,2–1,8× khá ổn định nhờ hợp nhất toán tử và loại bỏ chi phí điều phối của Python. Nhỏ hơn so với giảm độ chính xác, nhưng nó nhân chồng lên được và không đánh đổi độ chính xác.
Profiling CUDA xác định nút thắt nằm ở các kernel GEMM và ReLU — đây là phép kiểm chứng cho tất cả những điều trên. Chính việc GEMM chiếm ưu thế khiến giảm độ chính xác trở thành nước đi có đòn bẩy cao nhất; nếu profile cho thấy nghẽn ở băng thông bộ nhớ chỗ khác, thứ tự ưu tiên sẽ đảo ngược.
Kết luận
Với suy luận quy mô lớn, độ chính xác hỗn hợp và lượng tử hoá chiếm ưu thế. Tối ưu ở mức đồ thị vẫn đáng làm và đáng cộng dồn, nhưng nó là hệ số nhân trên một nền nhỏ hơn.
Điều tôi rút ra
Profiler giải quyết những tranh luận mà trực giác thua. Biết rằng GEMM và ReLU chiếm phần lớn thời gian chạy cho bạn biết ngay tối ưu nào mới có khả năng tạo khác biệt — và ngăn bạn dành cả tuần cho một hướng vốn về mặt toán học là không thể có tác dụng.